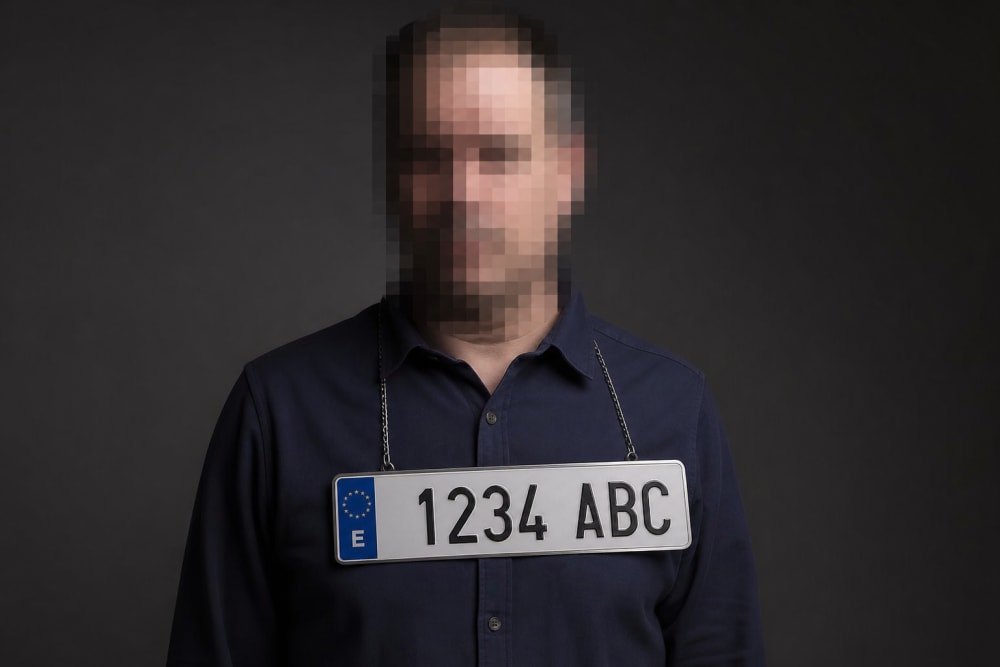
2. Qué carajo es de verdad anonimizar (y por qué seudonimizar NO es anonimizar)
Vamos a la ley.
Que aquí no venimos a opinar en el bar.
El RGPD —el Reglamento (UE) 2016/679— tiene un considerando que deberías tener tatuado.
El Considerando 26.
Dice, en cristiano, dos cosas que lo cambian todo:
Uno. Las reglas de protección de datos NO se aplican a la información anónima: la que no guarda relación con una persona identificada o identificable, o la que se ha convertido en anónima de forma que el interesado ya no puede ser identificado.
Dos —y agárrate—: para saber si alguien es identificable hay que tener en cuenta todos los medios que RAZONABLEMENTE puedan utilizarse, ya sea por ti o por cualquier otro, para identificarlo. Costes, tiempo, tecnología disponible.
¿Lo pillas?
Anónimo de verdad = imposible o irrazonablemente difícil volver atrás.
Para nadie.
Y ahora la trampa en la que cae casi todo el gremio.
Existe una cosa que se llama seudonimización.
Artículo 4.5 del RGPD.
Seudonimizar es tratar el dato de forma que ya no pueda atribuirse a una persona sin usar información adicional, información que guardas por separado y bajo llave.
¿Y sabes qué pasa con el dato seudonimizado?
Que SIGUE SIENDO DATO PERSONAL.
Sigue dentro del RGPD.
Sigue protegido.
Sigue siendo tu responsabilidad.
Porque la llave para volver atrás existe.
Y la tienes tú.
Cuando tú tachas el nombre pero dejas «trabajador de la empresa X, delegado sindical, despedido el 3 de marzo tras el ERE»… tú no has anonimizado.
Has seudonimizado de aquella manera.
Y encima mal.
La propia AEPD, junto al Supervisor Europeo, lo dejó por escrito en su documento «10 malentendidos relacionados con la anonimización» (2021): confundir seudonimización con anonimización es el error número uno.
Y no, cifrar tampoco es anonimizar —el cifrado es seudonimización, porque hay una clave que descifra—.
Encriptar no es anonimizar.
Tachar no es anonimizar.
Anonimizar es destruir el puente de vuelta a la persona.
Y eso, amigo, es mucho más trabajo del que creías.
3. El dato solo muerde a quien puede unir los puntos (el enfoque relativo del RGPD)
Aquí viene la idea que quiero que se te quede grabada a fuego.
La madre del cordero.
Un dato no es peligroso en abstracto.
Es peligroso en las manos adecuadas.
Te lo demuestro.
Si yo te doy un número de cuenta bancaria y tú no tienes acceso a NINGÚN sistema para saber de quién es… ese número, para ti, es basura.
Ruido.
No identifica a nadie.
Si te doy un DNI suelto y no hay forma humana de que averigües a quién pertenece… irrelevante.
Pero si ESE número o ESE DNI cae en manos de alguien que SÍ puede cruzarlo con una base de datos y ponerle cara y nombre… zas.
Ahí ya no es basura.
Ahí es un dato personal con todas las de la ley.
Y hay que protegerlo.
Esto tiene nombre técnico: enfoque relativo de la identificabilidad.
Y no me lo invento yo desde Canarias con una piña colada.
Lo dijo el TJUE en la sentencia Breyer (asunto C-582/14, de 19 de octubre de 2016): una dirección IP dinámica es dato personal solo respecto de quien dispone de medios legales razonables para, cruzándola, identificar al usuario.
Para el que no tiene esos medios, no lo es.
El dato es relativo.
Depende de quién lo tenga.
Y ahora agárrate fuerte, porque esto es lo más nuevo y lo más gordo.
El TJUE, en la sentencia C-413/23 P, EDPS contra la JUR (Junta Única de Resolución), de 4 de septiembre de 2025, lo ha confirmado con todas las letras.
El caso: la Junta Única de Resolución mandó a Deloitte comentarios de accionistas del Banco Popular seudonimizados —con un código en vez del nombre, y la llave para descifrar guardada solo por la Junta—.
¿Qué dijo el Tribunal de Justicia?
Que los datos seudonimizados NO son, en todo caso y para toda persona, datos personales.
Que la seudonimización puede, según las circunstancias, impedir de hecho que un tercero identifique a nadie, de modo que para ESE tercero el interesado ya no es identificable.
El mismo dato: personal para quien tiene la llave, no personal para quien no la tiene.
Justo lo que te acabo de contar del número de cuenta.
PERO —y este «pero» vale oro, cógelo— el Tribunal metió un matiz que a ti, profesional, te clava en la silla: el deber de informar y de proteger se mide en el momento de la recogida y desde la perspectiva de QUIEN CONTROLA el dato.
No desde la del que lo recibe después.
Traducido a tu despacho: que el texto sea «anónimo para la IA» NO te libra a TI de nada.
Porque tú SÍ tienes la llave.
Tú SÍ sabes quién es.
Tú SÍ eres el responsable.
El enfoque relativo protege al que recibe el dato limpio.
No al que lo suelta con la llave en el bolsillo.
Grábatelo: la anonimización solo tiene sentido si quien recibe el documento NO puede volver a la persona.
Si puede —o si tú se lo pones fácil dejando el relato entero— no has anonimizado nada.
Has hecho teatro.
4. El relato también delata: individualización, vinculabilidad e inferencia

Imagen generada con IA.
«Vale José María, pues quito el DNI, el nombre, el domicilio, el número de la Seguridad Social, la cuenta… y ya.»
No.
Otra vez no.
Porque los datos identificativos clásicos son la puerta de entrada más tonta.
La cerradura de juguete.
El problema de verdad está en el cuerpo del documento.
En la narración.
En los detalles.
El Grupo de Trabajo del Artículo 29 —los que mandaban en materia de protección de datos en Europa antes del Comité Europeo— publicó el Dictamen 05/2014 sobre técnicas de anonimización (WP216).
Un documento que deberías leerte una vez al año, como quien se hace la revisión del coche.
Y ahí explican que una anonimización de verdad tiene que resistir tres ataques.
Tres.
Si falla en uno, no vale:
1. Individualización (singling out). ¿Se puede aislar a UN individuo dentro del montón? Si en tu documento se puede señalar con el dedo «este, este de aquí es único»… has fallado. Ejemplo tonto: «la única mujer del turno de noche de la planta de Arrecife». No hace falta el nombre. Ya la has individualizado.
2. Vinculabilidad (linkability). ¿Se pueden CRUZAR dos datos o dos documentos y ver que hablan de la misma persona? Si alguien puede coger tu texto «anónimo» y enlazarlo con un LinkedIn, con una noticia, con otro expediente… has fallado.
3. Inferencia (inference). ¿Se puede DEDUCIR quién es a partir de lo que cuentas, aunque no lo digas? «Trabaja en la única bodega de un pueblo de seiscientos habitantes y lo despidieron la semana en que la bodega salió en el periódico local.» (Ejemplo inventado, ojo). No he dicho ni el nombre ni el cargo exacto. Pero cualquiera con Google lo saca en treinta segundos.
¿Ves por dónde voy?
Puedes tachar todos los DNI del mundo.
Si dejas la fecha exacta, el sector, el tamaño de la empresa, la localización, el cargo y «el detalle jugoso del caso»… has firmado la identidad de tu cliente con letras de neón.
El relato delata.
Siempre.
Y en un pueblo, en una isla, en un sector pequeñito donde todo el mundo se conoce… con dos datos de contexto ya está vendido.
5. Tachar el DNI es kindergarten: cuasi-identificadores y k-anonimato
Te presento a los verdaderos culpables: los cuasi-identificadores.
No son el DNI ni el nombre.
Son esos datos aparentemente inocentes que, combinados, cantan como un jilguero: edad, sexo, código postal, profesión, fecha de un hecho, categoría profesional, antigüedad, nº de hijos, centro de trabajo.
Cada uno por separado no dice nada.
Los tres o cuatro juntos apuntan a UNA persona.
Hay un estudio clásico, el de Latanya Sweeney (2000), que demostró que con código postal + fecha de nacimiento + sexo se podía identificar de forma única a cerca del 87 % de la población de Estados Unidos.
Sin nombre.
Sin DNI.
Solo con eso.
Por eso la anonimización seria trabaja con conceptos como el k-anonimato: que cada individuo sea indistinguible de, al menos, otras k-1 personas dentro del conjunto.
Que «la mujer del turno de noche» no sea una, sino un grupo de veinte donde no sabes cuál es.
Y sus hermanos mayores: la l-diversidad y la t-cercanía, que afinan todavía más para que no puedas inferir el dato sensible aunque tengas el grupo.
Y en la liga de los cracks, la privacidad diferencial.
¿Que suena a chino?
Vale.
No necesitas montar un doctorado en tu despacho.
Pero necesitas entender la idea: anonimizar bien es generalizar (poner «entre 40 y 50 años» en vez de «47»), agregar (hablar de «un centro del norte de la isla» en vez de «la nave de Tahíche»), y suprimir todo lo que individualice.
Y ojo, porque aquí la AEPD, en sus «Orientaciones y garantías en los procedimientos de anonimización», avisa de algo incómodo: el riesgo cero no existe.
La anonimización no es un botón mágico que deja la probabilidad de reidentificación en 0,000%.
Es un proceso de gestión del riesgo: reducirlo por debajo de un umbral razonable, controlando además la utilidad del dato.
Cuanto más anonimizas, menos útil es el documento.
Es un equilibrio.
Un oficio.
No un tachón.
6. Y ahora la h0stia: cuando le das de comer tus expedientes a la IA

Imagen generada con IA.
Todo lo anterior ya era importante hace diez años.
Hoy es cuestión de supervivencia profesional.
Porque antes el documento mal anonimizado se quedaba en un cajón, en un correo, en un pendrive.
Ahora lo estás subiendo a una IA.
Y cuando tú metes datos de un cliente en una IA pública y generalista, pasan varias cosas a la vez, y ninguna buena:
Estás haciendo un tratamiento de datos personales, con todo lo que eso implica en el RGPD.
Estás, potencialmente, haciendo una cesión a un tercero —el proveedor de la IA—. Y, según los términos de muchos servicios, esos datos pueden usarse para reentrenar el modelo, pueden ser revisados por personas de la compañía, y si hay una brecha de seguridad, quedan expuestos.
El propio Sam Altman, el jefe de OpenAI, lo dijo con la boca llena en julio de 2025, en el pódcast de Theo Von (lo recogió TechCrunch): las conversaciones con la versión pública de su IA no están protegidas por secreto profesional.
Que no metas ahí lo que no quieras que salga.
Y en Estados Unidos ya hay un juez que lo ha dicho en sede judicial: en febrero de 2026, Jed Rakoff, del Distrito Sur de Nueva York, resolvió en el asunto United States v. Heppner que los documentos que el acusado había preparado con un chatbot no estaban cubiertos por el privilegio abogado-cliente.
Ahora súmale nuestro talón de Aquiles.
Tú, como asesor laboral, como graduado social, como abogado, estás atado a un deber de secreto profesional.
Para los abogados está en el artículo 542.3 de la LOPJ: obligación de guardar secreto de todos los hechos que conozcan por razón de su actuación profesional.
Para los graduados sociales, el mismo deber de sigilo vive en su normativa colegial y deontológica.
No es una recomendación.
Es el suelo sobre el que se sostiene la confianza de tu cliente.
Y ese suelo se rompe en el segundo en que pegas un expediente identificable en una máquina que no controlas.
No porque la IA sea el diablo.
La IA es una herramienta acojonante.
Yo vivo de enseñar a sacarle el jugo.
Se rompe porque la usaste desnuda.
Sin anonimizar.
Confundiendo «quitar el DNI» con «proteger a mi cliente».
¡Tsjjjjank!
Ese es el sonido de la confianza haciéndose añicos.
7. El método para anonimizar de verdad ANTES de tocar una IA
Basta de sustos.
Vamos a lo práctico, que es lo que a ti te pone.
Antes de meter NADA en una IA, pásalo por este filtro.
Léelo como una conversación contigo mismo:
Primero: ¿de quién es esta historia? No mires solo el nombre. Mira el relato. Si un extraño leyera esto, ¿podría llegar a la persona? ¿A la empresa? ¿Al pueblo? Si la respuesta es «puede», sigue trabajando.
Segundo: mata los identificativos directos. Nombre, apellidos, DNI/NIE, nº Seguridad Social, cuenta bancaria, matrícula, dirección, email, teléfono. Fuera. Esto es el mínimo. El kindergarten. Que ya lo hacías.
Tercero, y aquí está el oro: mata los cuasi-identificadores por generalización. La fecha exacta → el mes o el trimestre. La edad → una horquilla. El puesto concreto → una función genérica. El centro de trabajo → una zona amplia. El sector muy específico → uno más general. La cifra exacta de la nómina → un rango.
Cuarto: pásale los tres exámenes del WP29. ¿Se puede individualizar a alguien? ¿Se puede vincular con otra fuente? ¿Se puede inferir quién es? Si cuela en los tres, vas bien.
Quinto: elige la herramienta adecuada. Para lo sensible, usa entornos con garantías: IA con contrato de encargado de tratamiento firmado, con compromiso de no reentrenar con tus datos, alojada donde toca. No la versión gratis de turno donde tus datos son la moneda con la que pagas.
Sexto: y aun así, anonimiza igual. Aunque la herramienta sea de fiar, el buen hábito es innegociable. Doble muro. Cinturón y tirantes.
Y una regla de oro que resume todo el artículo: no preguntes «¿he quitado los datos personales?».
Pregunta «¿podría alguien que reciba esto volver a mi cliente?».
Cambia la pregunta y cambia tu forma de trabajar.
Porque anonimizar no es una tarea de tachar.
Es una forma de respetar.
Y en este oficio, saltamontes, el respeto al cliente que confió en ti es lo único que no se puede reentrenar.
Para seguir leyendo: Pegaste el DNI de tu cliente en la IA. Ahora te cuento dónde está · Cifrado de acceso cero y servidores en Alemania: la IA que tu despacho puede usar sin saltarse el RGPD · Protección de datos en la relación laboral
8. Preguntas frecuentes
¿Anonimizar es lo mismo que quitar el nombre y el DNI?
No. Eso es apenas el primer paso, y el más obvio. Anonimizar de verdad implica eliminar o generalizar también los cuasi-identificadores y los detalles del relato (fechas, cargos, cifras, localización, sector) que permiten reidentificar a la persona por individualización, vinculación o inferencia. Quitar el DNI y dejar la historia entera es teatro, no anonimización.
¿Seudonimizar y anonimizar es lo mismo?
No, y confundirlos es el error más común (así lo señala la AEPD). El dato seudonimizado sigue siendo dato personal (art. 4.5 RGPD): existe una llave —guardada por separado— que permite volver a la persona. El dato anónimo ha destruido esa llave: ya no hay vuelta atrás razonable, y por eso queda fuera del RGPD (Considerando 26). Cifrar es seudonimizar, no anonimizar.
Si le quito los datos a un documento y se lo doy a alguien que no puede identificar a la persona, ¿ya está protegido?
Para ESE receptor, ese dato puede no ser personal (enfoque relativo: TJUE Breyer C-582/14 y C-413/23 P de 2025). Pero cuidado: si TÚ conservas la forma de reidentificar, para ti sigue siendo dato personal y sigues siendo responsable. La anonimización te protege frente a lo que sale; no borra tus obligaciones sobre lo que tú controlas.
¿Puedo usar ChatGPT u otra IA pública con datos de mis clientes?
Con datos identificables, no deberías. Introducirlos supone un tratamiento y, potencialmente, una cesión a un tercero que puede reentrenar el modelo o exponer la información. Choca de frente con el RGPD y con tu deber de secreto profesional (art. 542.3 LOPJ para abogados; deber de sigilo para graduados sociales). Si vas a usar IA, anonimiza antes y trabaja con herramientas que ofrezcan garantías contractuales.
¿Existe la anonimización perfecta, con riesgo cero de reidentificación?
No. La AEPD lo advierte expresamente: la anonimización es gestión del riesgo, no eliminación absoluta. El objetivo es reducir la probabilidad de reidentificación por debajo de un umbral razonable manteniendo cierta utilidad del dato. Cuanto más anonimizas, menos útil es el documento; ahí está el oficio.
¿Qué es el k-anonimato y para qué me sirve en la práctica?
Es un criterio técnico según el cual cada individuo debe ser indistinguible de, al menos, otras k-1 personas del conjunto. En cristiano: que «la trabajadora del turno de noche» no sea una sola, sino parte de un grupo donde no se puede saber cuál es. En tu día a día se traduce en generalizar y agregar datos en lugar de dejarlos exactos.
¿Y si trabajo en una isla o en un sector muy pequeño donde todos se conocen?
Extrema la precaución. Cuanto más pequeño es el universo, menos datos hacen falta para reidentificar. Ahí la inferencia es letal: dos detalles de contexto bastan. Generaliza mucho más y, si el caso es muy singular, plantéate no volcarlo en ninguna IA.
9. Glosario
Dato personal
Toda información sobre una persona física identificada o identificable, directa o indirectamente (art. 4.1 RGPD).
Anonimización
Proceso que transforma un dato personal para que el interesado deje de ser identificable de forma razonable, por cualquiera. El dato anónimo queda fuera del RGPD (Considerando 26).
Seudonimización
Tratamiento que impide atribuir el dato a una persona sin información adicional guardada por separado (art. 4.5 RGPD). Sigue siendo dato personal.
Enfoque relativo de la identificabilidad
Criterio según el cual un dato es o no personal según los medios razonables de reidentificación de quien lo tiene (TJUE Breyer C-582/14; TJUE C-413/23 P).
Medios razonables
Conjunto de recursos —tiempo, coste, tecnología— que razonablemente podrían usarse para reidentificar. Es la vara de medir del Considerando 26.
Cuasi-identificador
Dato que por sí solo no identifica, pero que combinado con otros sí (edad, sexo, código postal, profesión, fecha de un hecho, centro de trabajo).
Individualización (singling out)
Poder aislar a un individuo concreto dentro de un conjunto de datos.
Vinculabilidad (linkability)
Poder enlazar dos registros o documentos referidos a la misma persona.
Inferencia (inference)
Poder deducir la identidad o un atributo de una persona a partir de otros datos, aunque no figure expresamente.
k-anonimato
Garantía de que cada individuo es indistinguible de, al menos, otras k-1 personas del conjunto. Sus refinamientos son la l-diversidad y la t-cercanía.
Privacidad diferencial
Técnica avanzada que introduce «ruido» matemático controlado para impedir extraer información sobre un individuo concreto sin destruir la utilidad estadística del conjunto.
Secreto profesional
Deber de confidencialidad sobre los hechos conocidos por razón de la actuación profesional (art. 542.3 LOPJ para abogados; deber de sigilo colegial para graduados sociales).
Reidentificación
Proceso inverso: volver a asociar un dato «anonimizado» con la persona a la que pertenece.
10. Fuentes y referencias
Reglamento (UE) 2016/679 (RGPD) — Considerando 26 y artículo 4 (definiciones)
Grupo de Trabajo del Artículo 29 — Dictamen 05/2014 sobre técnicas de anonimización (WP216), versión española (AEPD)
AEPD y SEPD — «10 malentendidos relacionados con la anonimización» (2021)
AEPD — «Orientaciones y garantías en los procedimientos de anonimización de datos personales»
TJUE, sentencia Breyer, asunto C-582/14, de 19 de octubre de 2016
TJUE, sentencia C-413/23 P, EDPS/JUR (SRB), de 4 de septiembre de 2025 — nota de prensa nº 107/25
Tribunal General, sentencia SRB/EDPS, T-557/20, de 26 de abril de 2023
AEPD — Guía «Adecuación al RGPD de tratamientos que incorporan Inteligencia Artificial»
Ley Orgánica 6/1985, de 1 de julio, del Poder Judicial — artículo 542.3 (secreto profesional de los abogados)
AEPD — Notas de prensa sobre errores comunes en machine learning y protección de datos